Kimi K3 Brings Open Weights Closer to Frontier Agents
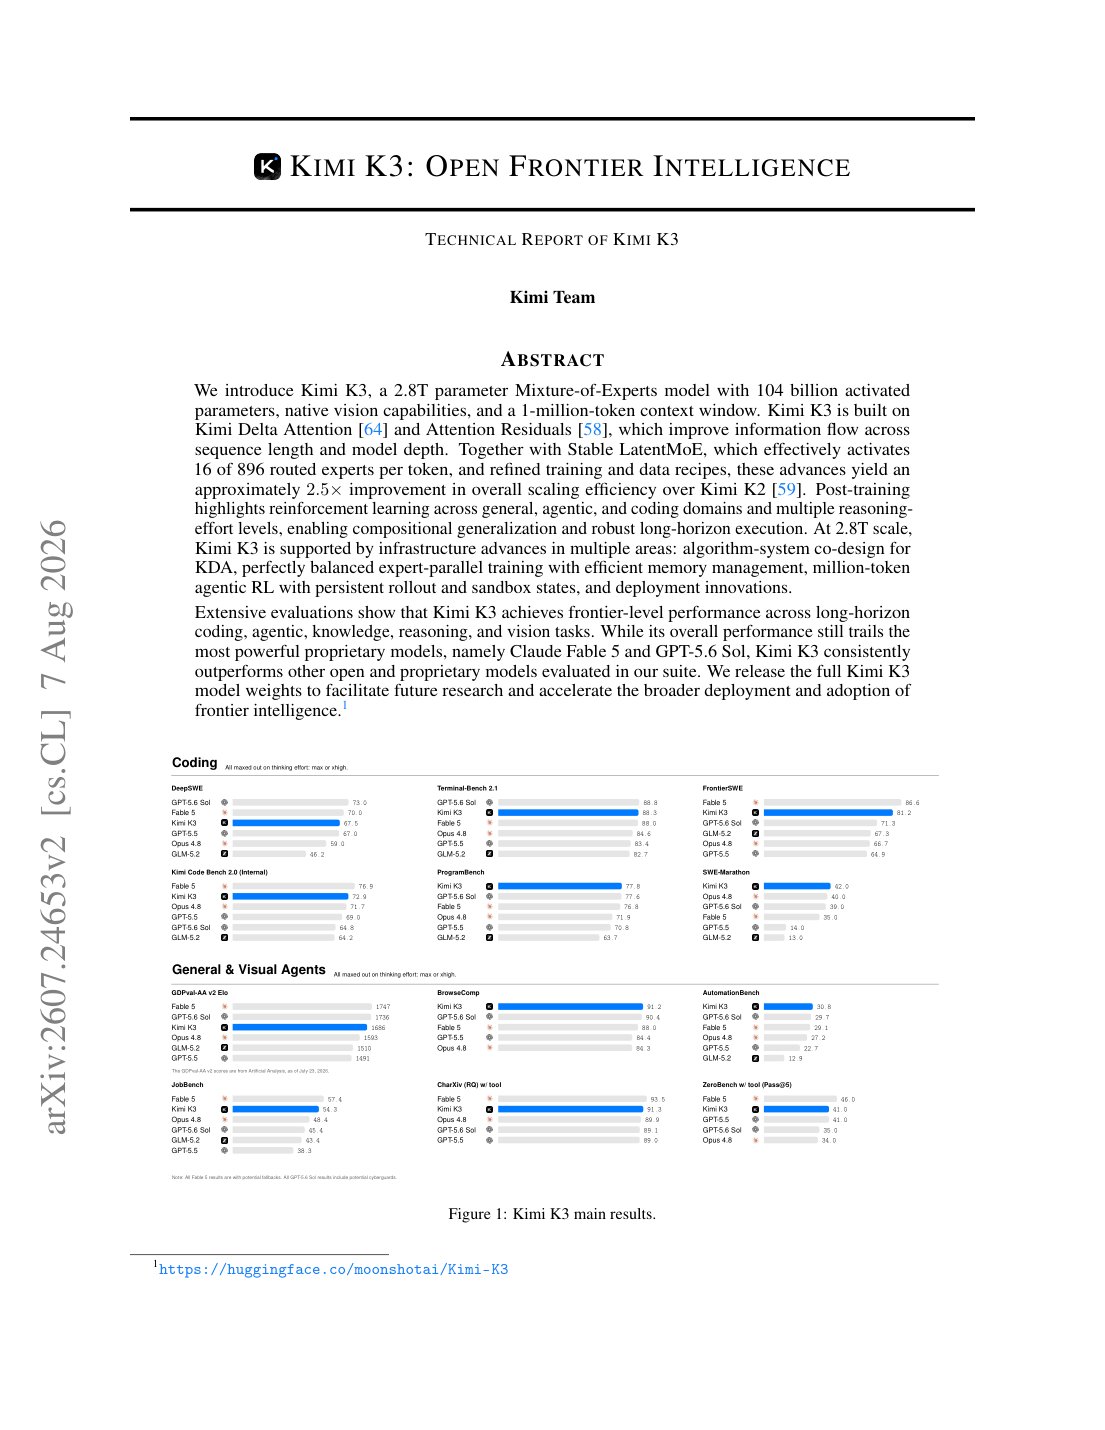
A 2.8T-parameter MoE combines Delta Attention, 16-of-896 expert routing, and agentic reinforcement learning to approach leading proprietary systems at lower task cost.
Aug 10, 20264 min2607.24653
3 articles on SOTA Papers
A 2.8T-parameter MoE combines Delta Attention, 16-of-896 expert routing, and agentic reinforcement learning to approach leading proprietary systems at lower task cost.
ROCS separates request-side and candidate-side computation, reaching up to 3× higher retrieval QPS and 50% higher ranking QPS in production.
Long-horizon trajectories, domain teachers, and routed on-policy distillation produce 56.4 on SEAL-0 and 80.6 on IFBench.