Kimi K3 Brings Open Weights Closer to Frontier Agents
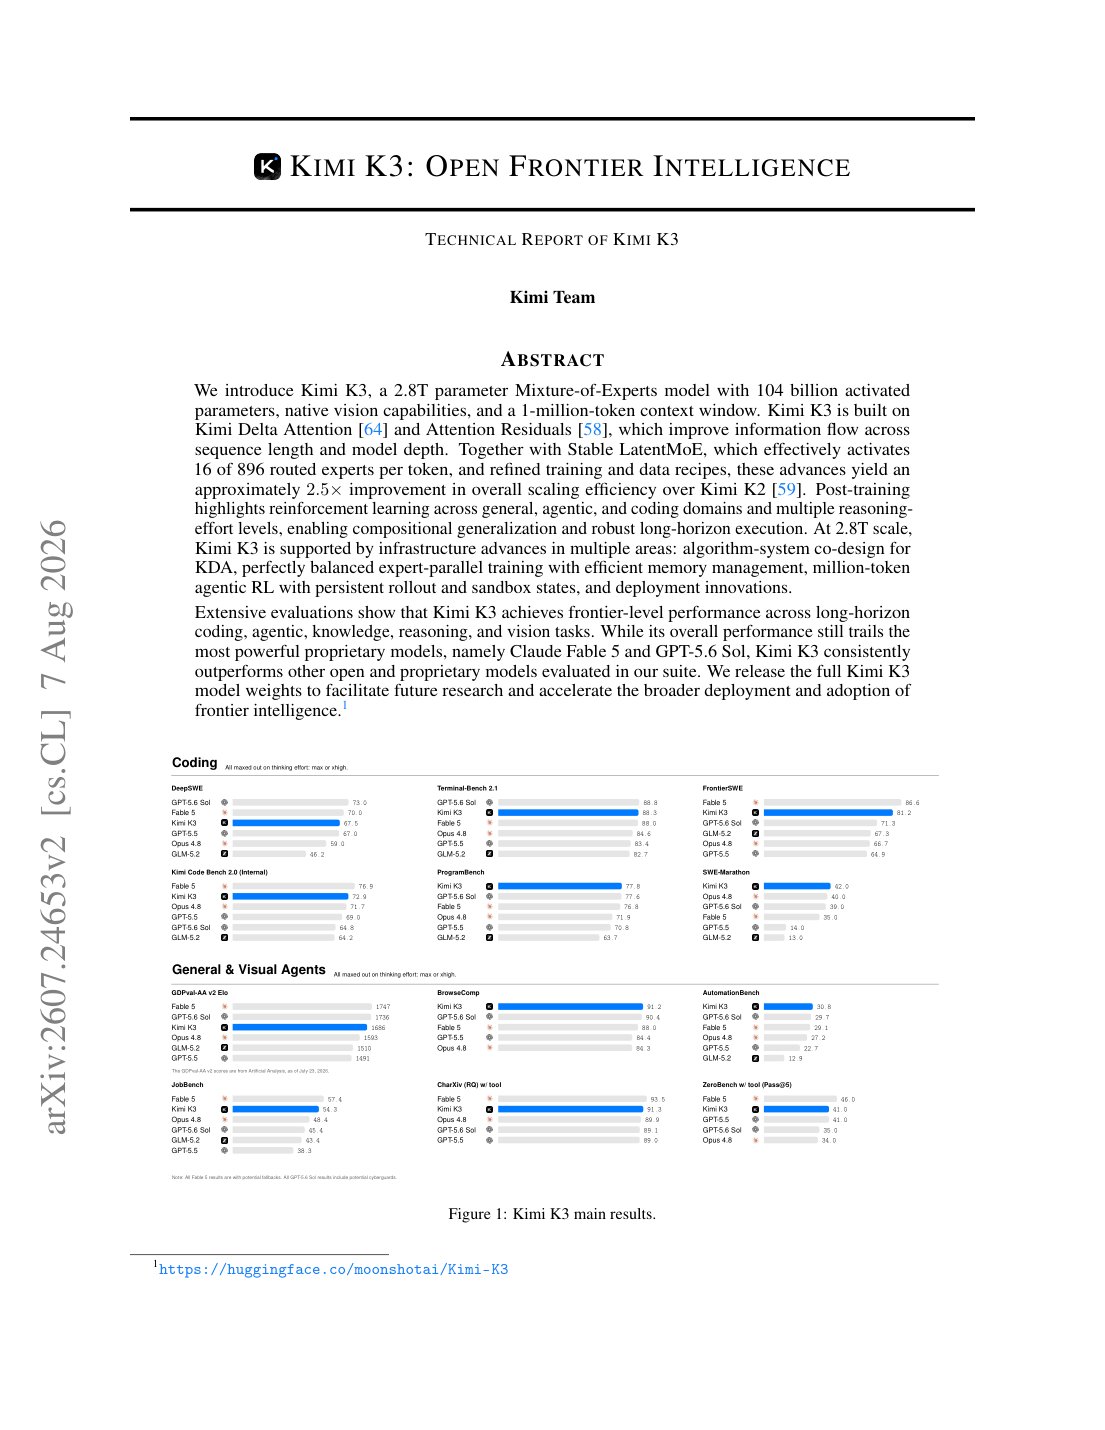
A 2.8T-parameter MoE combines Delta Attention, 16-of-896 expert routing, and agentic reinforcement learning to approach leading proprietary systems at lower task cost.
Aug 10, 20264 min2607.24653
2 articles on SOTA Papers
A 2.8T-parameter MoE combines Delta Attention, 16-of-896 expert routing, and agentic reinforcement learning to approach leading proprietary systems at lower task cost.
Polarization sensing and RRAM-based task traction distill regions of interest, reaching 193 μs execution and 30.6× lower latency than SOTA baselines.
