Xie Chen

3 articles on SOTA Papers

UltraVoice Improves Fine-Grained Control in Spoken Dialogue Models

A curated 830-hour dialogue dataset couples style-conditioned instructions with synthesized speech, raising multi-dimensional control scores without reported losses in conversational capability.

Sep 6, 20264 min2510.22588 Code available
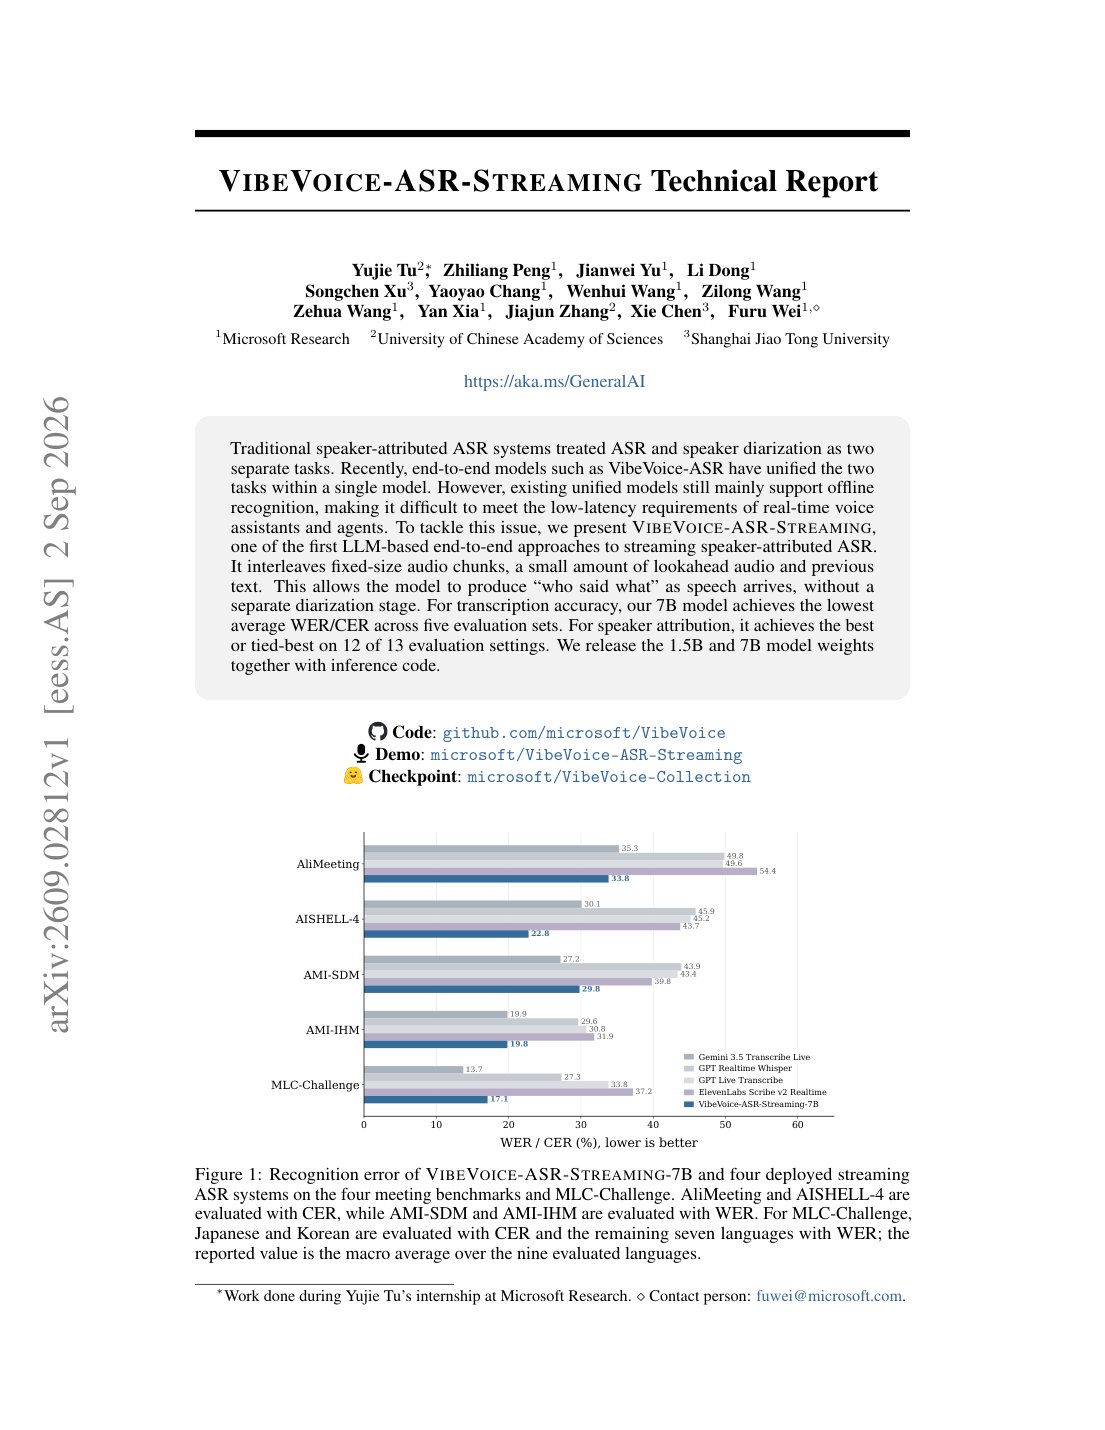
Streaming ASR Unifies Transcription and Speaker Attribution

VibeVoice-ASR-Streaming interleaves audio, lookahead, and prior text so one model can produce speaker-attributed transcripts as speech arrives.

Sep 4, 20263 min2609.02812

GigaSpeechBench Exposes ASR Gaps Beyond Standard Benchmarks

A 680-hour human-annotated benchmark combines multilingual, dialect, accent, domain, and age stress tests across ASR and speech translation.

Jul 28, 20265 min2606.28884